用 Agent 做科学研究的超算互联网用户们,免费好用的科研文献检索神器来了!
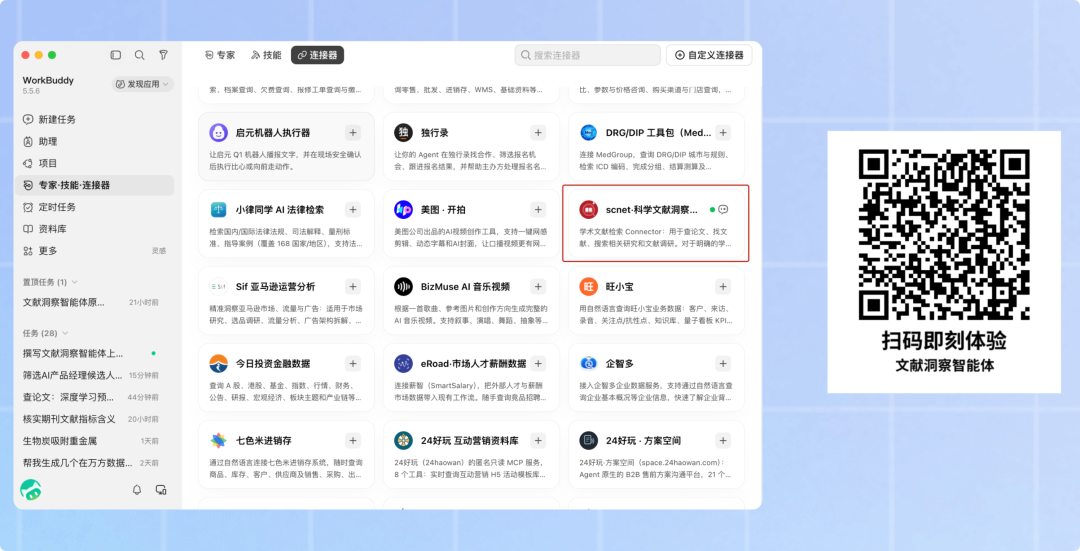
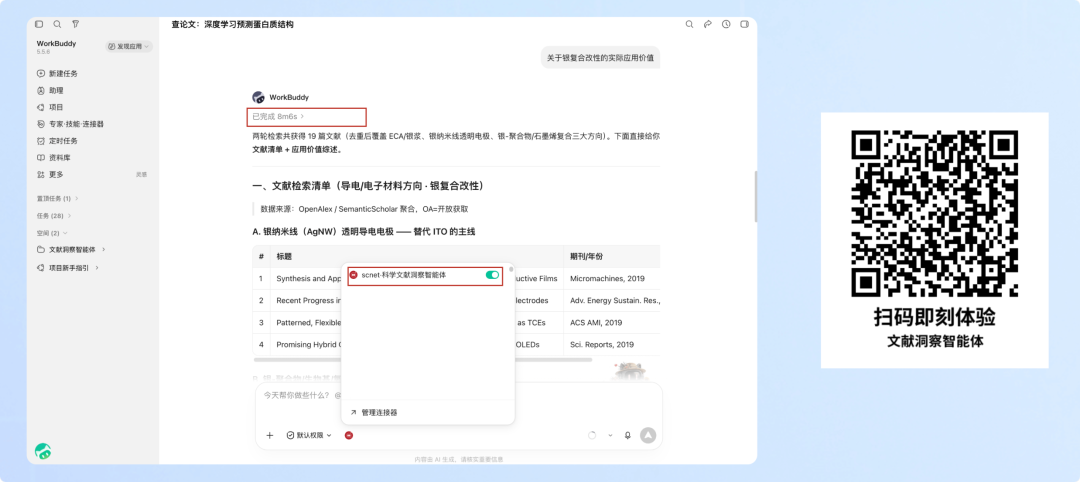
即日起,在腾讯 WorkBuddy 的连接器管理页面找到「科学文献洞察智能体」,一键添加即可启用。此后,用一句自然语言描述检索需求,WorkBuddy便可并行检索 Crossref、Semantic Scholar、OpenAlex 等多个权威学术数据源,将结果聚合、去重,整理为结构化的文献清单。
而在检索能力之上,科学文献洞察智能体真正区别于通用搜索的,是它对“可信”的坚持:每一条结果都来自真实检索、标注确切来源—不虚构、不补造、不将 AI 推断冒充为数据库事实。对科研工作而言,一条可以放心引用的文献,远比十条来路不明的结果更有价值。
这意味着,WorkBuddy 在通用能力之外,正式具备了面向学术场景、可信可溯源的专业文献检索能力。
科研文献检索的现实困境
文献调研贯穿选题、综述、投稿自查、开题论证等多个环节,但这一环的效率损耗远比”多开几个网页”更深:
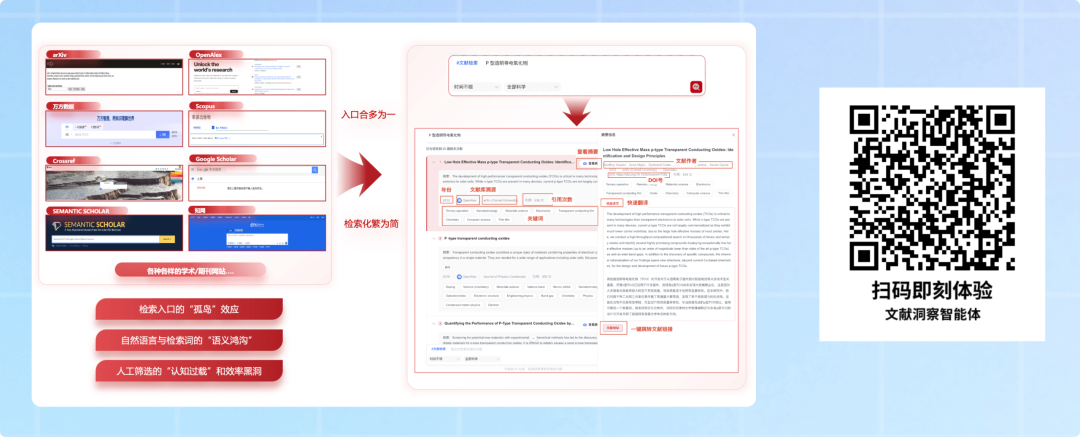
- 检索孤岛——Crossref、Semantic Scholar、知网等数据库各自独立,需逐一检索、人工拼合;关键词一旦选偏,还容易陷入”搜什么才看得到什么”的信息茧房。
- 语义鸿沟——脑中的科研问题难以精准翻译成检索词,关键词的细微差异就可能漏掉关键文献,甚至让人误以为”没人做过”。
- 认知过载——一个方向动辄成千上万篇,人工只能抽样,还要反复去重、整理,大量时间耗在”搬运信息”而非”思考问题”。
- 可信存疑——来源不固定、低质信息混杂,而选题一旦建立在”伪创新”或他人已做过的问题上,代价可能是数月乃至一两年的研究方向偏差。
科学文献洞察智能体的核心能力
科学文献洞察智能体不是简单的关键词匹配,而是一套面向科研的多源文献检索与聚合体系——把自然语言问题,转化为可信、结构化、可直接引用的文献结果。核心能力围绕一条主轴:可信。
- 结果真实、来源可溯(核心)——所有标题、作者、DOI、摘要、引用数均来自真实检索,绝不虚构;每条都标注来源、保留原文链接,可逐条回溯核验。
- 事实与推断分离——做分析时,”检索到的客观事实”与”AI 得出的结论”分区呈现,绝不把模型推断当作文献事实。
- 空结果与错误如实反馈——”没检索到”不等于”没有研究”,工具异常、超时也会如实说明,绝不以虚构结果敷衍。
- 多库并行检索——一次检索同时覆盖 Crossref、Semantic Scholar、OpenAlex 等权威数据源,兼顾正式出版物与前沿预印本。
- 聚合去重 + 结构化——重复文献自动合并并标注全部来源,每篇整理为齐整的结构化元数据,条目或表格随取随用。
- 自然语言检索——中英文自然语言提问即可,无需构造检索式;原始问题原样理解,含”近五年”等限定完整保留,检索意图不被扭曲。
WorkBuddy+文献洞察智能体:1+1>2
关于 WorkBuddy 与连接器
WorkBuddy 是腾讯团队推出的全场景职场 AI 智能体桌面工作台。其”连接器”功能基于标准化协议(如 MCP)构建,让 AI 无需手动切换工具,即可直接调用外部专业能力,摆脱反复复制粘贴的工作方式。科学文献洞察智能体,正是承担”学术文献检索”这一职能的专业连接器。
科学文献洞察智能体
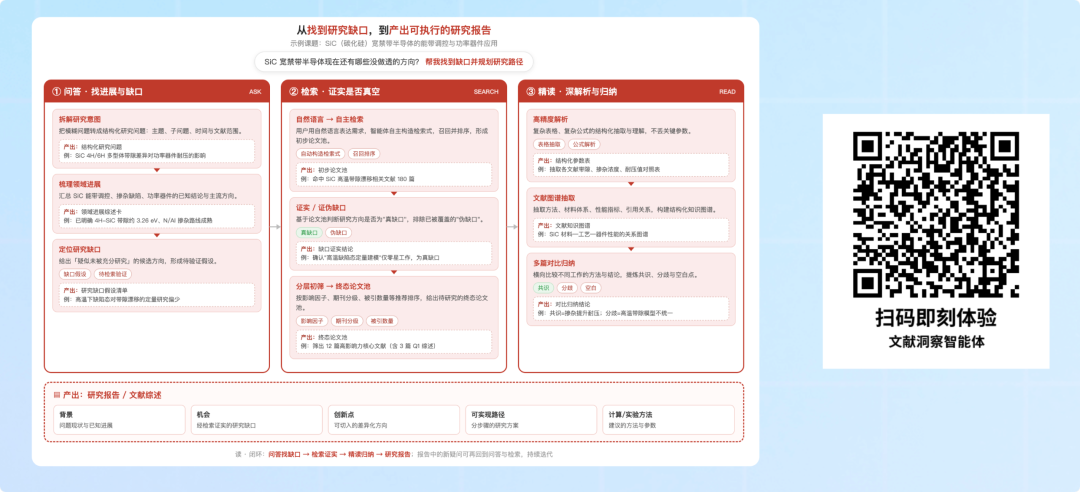
此前 WorkBuddy 虽有通用联网搜索,但面对严肃学术调研仍力有不逮:结果易混入非学术内容、元数据不全、难以去重、也难覆盖多个专业库。接入科学文献洞察智能体后,只需三步即可闭环:
- 用自然语言下达检索指令(如”检索近一年高分子材料在航空器上应用的相关文献,10 篇”);
- WorkBuddy 调用科学文献洞察智能体,并行检索多个学术库并聚合去重;
- 基于结构化结果继续整理成表、生成清单、梳理综述、导出文档。
全程无需离开工作台。作为连接器,它还能与其他能力联动——把检索结果导出为 Word / Excel 清单,或交由 AI 梳理成研究现状报告,实现从”检索文献”到”完成综述”的连贯工作流。
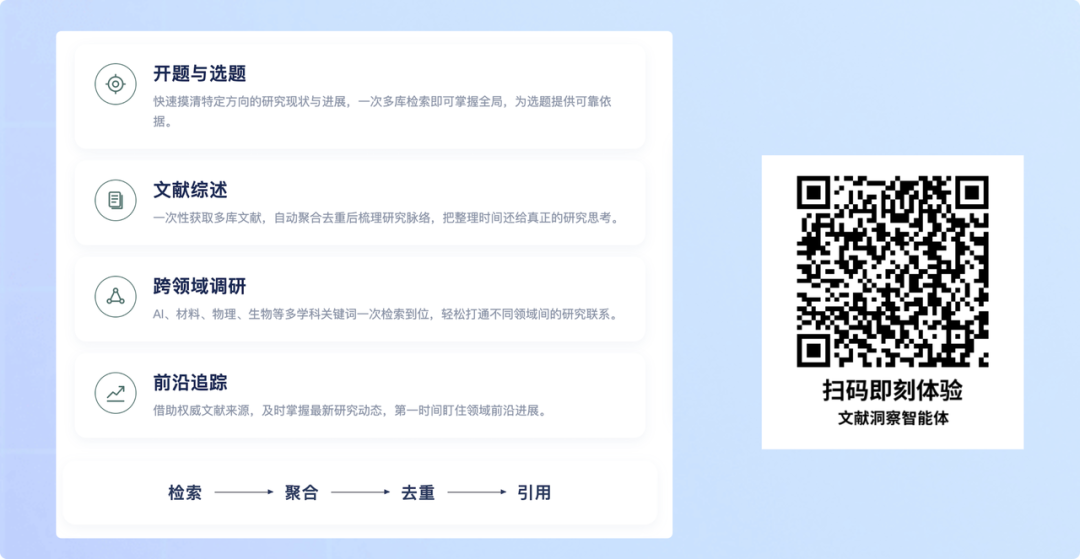
典型应用场景
免费体验:三步启用
- 登录 WorkBuddy,点击左侧导航栏「连接器」;
- 找到「科学科学文献洞察智能体」卡片,点击「+」一键添加;
- 用自然语言直接下达检索指令,无需编写检索式或代码。
使用说明与边界
为保证结果的严谨性与可信度,需说明:
科学文献洞察智能体提供的是文献元数据与摘要(标题、摘要、作者、DOI、来源、链接等)。能否获取全文,取决于该文献是否开放获取或用户所在机构的订阅权限;服务不会绕过付费墙,也不会将付费文献声称为可免费获取。
本文转载自微信公众号「gh_b6e55a8ecd28 · 超算互联网」,阅读原文。